Memoria escasa y IA en casa: el argumento de Altman contra los modelos locales
El director ejecutivo de OpenAI sostiene que usar la memoria DRAM de las computadoras personales para correr modelos es una mala asignación, en medio de una fuerte suba de precios.
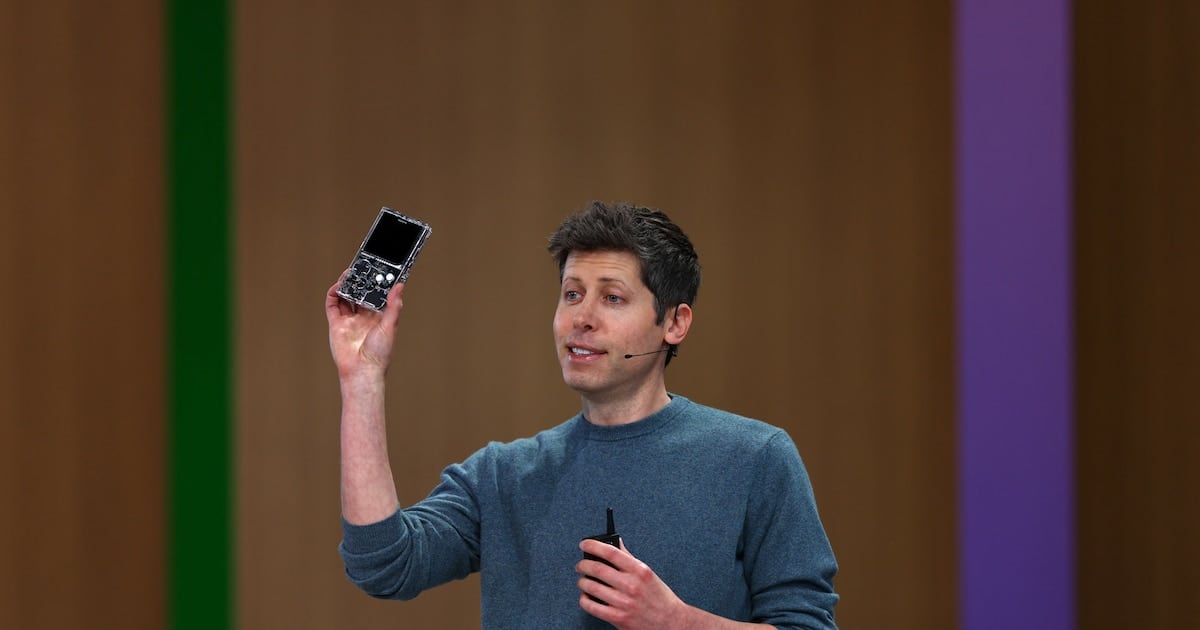
¿Conviene tener un modelo de inteligencia artificial corriendo en la propia computadora o es mejor delegarlo en la nube? La pregunta dejó de ser técnica y pasó a tener que ver con la memoria, un componente que hoy está caro y escaso.
Sam Altman, director ejecutivo de OpenAI, sostuvo que ejecutar modelos directamente en equipos domésticos representa una mala asignación de la memoria DRAM, cuyo precio subió entre un 90% y un 95% en el primer trimestre de 2026. Según su planteo, concentrar ese recurso en centros de datos de uso continuo generaría un mayor rendimiento.
Un recurso que casi no se usa
Altman calculó que la memoria instalada en una computadora personal está inactiva la mayor parte del día y que su uso efectivo ronda el 5% del tiempo. Lo presentó como un problema de asignación de recursos justo cuando el componente escasea en todo el mundo.
“La inferencia local es una terrible asignación de recursos escasos.”Sam Altman
La frase la dijo en una entrevista en el pódcast Cheeky Pint, conducido por John Collison, cofundador de Stripe. Allí also cuestionó que mucha gente asuma que el problema está resuelto porque ya existen modelos de código abierto que se pueden ejecutar en las computadoras.
Lo que dicen los números y los dos argumentos
Según TrendForce, los precios de la DRAM aumentaron entre un 90% y un 95% durante el primer trimestre de 2026. Fabricantes como Micron y SK Hynix no logran escalar la producción al ritmo que piden los grandes operadores de centros de datos dedicados a IA.
- Un centro de datos aprovecha la misma memoria las 24 horas.
- Una computadora personal la usa una fracción mínima del día.
- Con oferta restringida, dispersarla en millones de equipos reduce el rendimiento global.
Quienes defienden la IA local responden con el argumento de la privacidad: procesar los datos en el propio equipo, sin enviarlos a servidores externos.